목차
- 상황
- 왜 32비트에서 64비트 DLL 을 부를 수 없는가
- 중개 프로세스와 IPC 선택지
- 왜 공유 메모리가 빠른가
- 그런데 왜 100배 느렸는가
- 결론과 판단 기준
- 요약
1. 상황
HMI 편집 도구는 오래된 32비트 응용프로그램임. 함께 배포되는 기능 DLL 들도 전부 32비트로 빌드됨.
그런데 같은 DLL 들이 다른 제품군(런타임·뷰어)을 위해 이미 64비트로 마이그레이션이 끝난 상태였음.
-> 같은 기능의 DLL 이 32비트 한 벌, 64비트 한 벌. 두 벌이 됨.
-> 고치면 두 곳을 고쳐야 하고, 빌드도 두 번, 테스트도 두 번임.
그래서 한 벌로 합치고 싶었음. 편집 도구가 64비트 DLL 을 그대로 쓰면 끝나는 이야기였음.
<-> 그런데 안 됨. 여기서부터가 이 글의 내용임.
2. 왜 32비트에서 64비트 DLL 을 부를 수 없는가
먼저 "DLL 을 부른다"가 무엇인지부터 분명히 할 필요가 있음.
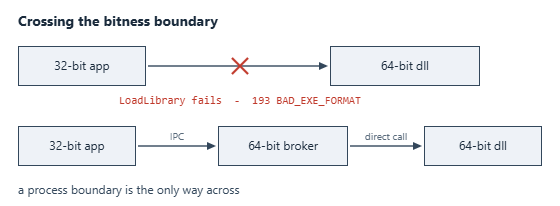
DLL 을 로드한다는 것은 원격의 무언가에 요청을 보내는 것이 아님.
-> 그 코드를 내 프로세스의 주소 공간에 올려놓는 것임.
-> 로드된 DLL 은 나와 같은 메모리를 보고, 같은 스택을 쓰고, 같은 힙에서 할당받고, 같은 CPU 모드에서 실행됨.
=> 그러니 비트수가 다르면 애초에 한 지붕 아래 있을 수가 없음. 네 가지가 전부 어긋남.
(1) 포인터 크기가 다르다
32비트는 포인터가 4바이트, 64비트는 8바이트임. 그리고 그것으로 끝이 아님.
struct FrameHeader {
    unsigned short  nType;      // 2 바이트
    void*           pPayload;   // 32비트 4 / 64비트 8
    size_t          nLength;    // 32비트 4 / 64비트 8
};

// 32비트 : nType(2) + 패딩(2) + pPayload(4) + nLength(4)  =  12
// 64비트 : nType(2) + 패딩(6) + pPayload(8) + nLength(8)  =  24
- 포인터를 품은 구조체는 전체 크기와 내부 오프셋이 전부 달라짐.
-> 정렬 규칙이 겹치므로 단순한 덧셈도 아님. 패딩이 어디에 얼마나 들어가는지가 달라짐.
-> size_t, long, 핸들 타입처럼 크기가 플랫폼에 따라 바뀌는 타입이 하나만 섞여 있어도 같은 일이 벌어짐.
(2) 호출 규약이 다르다
함수를 부를 때 인자를 어디에 싣고 누가 스택을 치우는지는 약속임. 이 약속이 32비트와 64비트에서 다름.
- 32비트에는 규약이 여럿임. 인자를 쌓는 순서, 스택 정리 책임, 일부 인자의 레지스터 전달 여부가 규약마다 다름.
- 64비트는 사실상 하나로 통일됨. 앞쪽 인자는 정해진 레지스터로, 나머지는 스택으로 감.
-> 게다가 호출하는 쪽이 스택에 여유 공간을 미리 비워두는 규칙이 있음. 함수가 레지스터로 받은 인자를 필요하면 그 자리에 쏟아둘 수 있게 하는 공간임.
=> 같은 함수 서명이라도 기계 수준에서는 인자가 실려 오는 자리 자체가 다름.
(3) CPU 실행 모드가 다르다
프로세서는 현재 코드 세그먼트 설정에 따라 명령어를 32비트 모드 또는 64비트 모드로 해석함.
-> 한 프로세스는 하나의 모드로 돎. 스레드마다 모드를 바꿔 끼우는 일은 운영체제가 지원하지 않음.
=> 같은 프로세스 안에서 두 아키텍처의 코드를 섞어 실행한다는 것 자체가 성립하지 않음.
(4) 애초에 로더가 막는다
실행 파일과 DLL 의 헤더에는 대상 아키텍처가 박혀 있음. 로더가 가장 먼저 그것을 봄.
HMODULE hDll = LoadLibraryW(L"driver_x64.dll");
if (hDll == NULL) {
    const DWORD dwErr = GetLastError();
    // 193  ERROR_BAD_EXE_FORMAT
    // 32비트 프로세스에서 64비트 이미지를 올리려 했을 때 돌아오는 값
    LogError("LoadLibrary failed : %lu", dwErr);
}
- 함수를 잘못 불러서 나는 런타임 오류가 아님. 로드 자체가 거부됨.
=> 즉 이것은 "잘 짜면 되는" 문제가 아니라 프로세스 경계로만 넘을 수 있는 벽임.
덧 — 그러면 64비트 윈도우에서 32비트 프로그램은 어떻게 도는가
64비트 윈도우는 32비트 프로세스를 위한 호환 계층을 가지고 있음. 그래서 편집 도구가 아무 문제 없이 돌고 있음.
<-> 다만 이것은 32비트 프로세스를 32비트인 채로 돌려주는 장치임. 64비트 코드를 섞어주는 장치가 아님.
부수 효과도 있음.
- 32비트 프로세스가 시스템 디렉터리를 열면 다른 폴더로 돌려짐. 레지스트리도 일부가 갈라짐.
-> 경로를 적어두고 쓰는 코드가 있으면 "분명히 있는 파일인데 없다고 나오는" 증상으로 나타남.
- 32비트 프로세스의 주소 공간은 여전히 좁음. 기본 2GB, 플래그를 켜도 4GB 를 넘지 못함.
덧 — COM 은 비트수가 달라도 되던데
맞음. 그래서 예외처럼 보임. 그런데 예외가 아님.
-> 비트수가 맞으면 COM 은 그냥 DLL 을 올려 같은 프로세스에서 씀. 이때는 빠름.
-> 비트수가 다르면 별도 프로세스에 서버를 띄우고, 호출 인자를 포장해 넘기고 결과를 되받음.
=> 즉 COM 도 결국 중개 프로세스 + IPC 임. 그 구조가 우리 눈에 안 보이게 감춰져 있을 뿐이고, 비용은 그대로 듦.
-> 이 사실이 뒤에서 다시 중요해짐. "COM 을 쓰면 되지 않나"는 사실 "IPC 를 쓰면 되지 않나"와 같은 말임.
3. 중개 프로세스와 IPC 선택지
벽을 넘는 방법은 하나뿐임. 64비트 프로세스를 하나 두는 것.
- 편집 도구(32비트)가 중개 프로세스(64비트)에 요청을 보냄.
- 중개 프로세스는 비트수가 같으므로 64비트 DLL 을 직접 부름.
- 결과를 되돌려줌.
구조는 단순함. 문제는 둘 사이를 무엇으로 잇는가였음. 네 가지를 놓고 봤음.
비교 기준은 셋이었음 — 데이터 복사 횟수, 커널을 드나드는 횟수, 구현과 운영 부담.
네임드 파이프
- 커널이 관리하는 통신 객체. 이름으로 찾아 열고, 파일처럼 읽고 씀.
- 메시지 모드가 있어 보낸 단위가 그대로 보존됨. 경계를 직접 자를 필요가 없음.
- 로컬은 물론 다른 장비와도 됨. 인증도 붙어 있음.
-> 비용은 복사 2회. 보내는 쪽 버퍼에서 커널 버퍼로 한 번, 커널 버퍼에서 받는 쪽 버퍼로 한 번.
-> 그리고 읽기·쓰기마다 시스템 호출이 들어감.
TCP 소켓 (루프백)
- 가장 익숙하고 디버깅 도구도 많음. 나중에 중개를 다른 장비로 떼어내기도 쉬움.
<-> 대신 네트워크 스택을 통째로 지나감. 헤더 조립, 체크섬, 큐잉, 혼잡 제어.
-> 루프백이라 실제 랜카드로 나가지는 않지만 스택 처리 비용은 그대로 듦.
-> 게다가 스트림이라 메시지 경계가 없음. 길이 헤더를 직접 붙이고 잘라야 함.
=> 네 방식 중 가장 무거움. 같은 PC 안에서 쓰기에는 낭비가 큼.
COM (프로세스 외부 서버)
- 인터페이스만 정의하면 포장·해체 코드가 만들어짐. 개발 부담이 가장 적음.
- 등록, 권한, 생명주기를 운영체제가 관리해줌. 중개를 언제 띄울지 신경 쓰지 않아도 됨.
<-> 대신 기존 DLL 의 C 함수 서명을 인터페이스로 다시 그려야 함. 수십 개 함수를 전부.
<-> 그리고 앞에서 본 대로 내부적으로는 결국 프로세스 사이 통신임. 파이프보다 낫지만 공짜가 아님.
공유 메모리
- 같은 물리 페이지를 두 프로세스의 가상 주소 공간에 각각 매핑함.
- 한쪽이 쓰면 다른 쪽에서 즉시 보임. 복사가 아예 없음.
<-> 대신 "지금 읽어도 되는가"를 알려주는 장치가 따로 필요함. 이벤트, 뮤텍스, 세마포어.
=> 속도만 놓고 보면 명백히 이쪽. 그래서 공유 메모리로 정했음.
4. 왜 공유 메모리가 빠른가
이름 붙인 매핑 객체를 만들고, 두 프로세스가 같은 이름으로 엶.
// 중개 프로세스 쪽 : 영역과 신호를 만든다
HANDLE hMap = CreateFileMappingW(INVALID_HANDLE_VALUE, NULL,
                                 PAGE_READWRITE, 0, kRegionSize,
                                 L"Local\\BrokerRegion");

void* pView = MapViewOfFile(hMap, FILE_MAP_ALL_ACCESS, 0, 0, kRegionSize);

// 데이터가 준비됐음을 알리는 신호는 따로 둔다
HANDLE hRequest  = CreateEventW(NULL, FALSE, FALSE, L"Local\\BrokerRequest");
HANDLE hResponse = CreateEventW(NULL, FALSE, FALSE, L"Local\\BrokerResponse");
- 파일을 쓰지 않고 페이지 파일 지원 매핑을 씀. 디스크 파일이 필요하지 않음.
- 이름 앞의 접두사는 세션 범위를 정함. 서비스와 데스크톱 사이라면 범위를 잘못 잡아 서로 못 찾는 일이 생김.
⛔ 매핑된 주소는 프로세스마다 다르다
같은 물리 페이지를 보고 있어도, 그 페이지가 내 주소 공간의 어디에 붙었는지는 서로 다름.
-> 그래서 공유 영역 안에서는 포인터를 쓸 수 없음. 내 주소는 상대에게 의미가 없음.
-> 영역 시작점으로부터의 오프셋으로 표현해야 함.
여기에 앞에서 본 포인터 크기 문제가 그대로 이어짐. 32비트 쪽과 64비트 쪽이 같은 바이트 배열을 똑같이 해석해야 함.
// 공유 영역에 얹는 구조체는 이렇게 다시 정의한다
#pragma pack(push, 1)
struct WireHeader {
    uint32_t nMagic;          // 고정 폭 정수만 쓴다
    uint16_t nVersion;        // 프로토콜 버전. 양쪽이 다를 수 있다
    uint16_t nOpCode;
    uint32_t nPayloadOffset;  // 포인터가 아니라 영역 시작점 기준 오프셋
    uint32_t nPayloadSize;
    int32_t  nResult;
};
#pragma pack(pop)

static_assert(sizeof(WireHeader) == 20, "wire layout changed");
- int, long, size_t, 포인터, 열거형을 그대로 쓰지 않음. 크기가 고정된 타입만 씀.
- 패딩을 컴파일러에게 맡기지 않고 명시적으로 정함.
- 크기를 컴파일 시점에 검사해 둠. 양쪽 중 한쪽만 구조체가 바뀌는 사고를 막음.
- 버전 필드를 처음부터 넣어둠. 중개와 편집 도구가 따로 배포되면 버전이 어긋나는 순간이 반드시 옴.
복사가 없다는 것의 의미
한 번 왕복할 때 실제로 일어나는 일을 세어보면 차이가 분명해짐.
파이프·소켓
(1) 내 버퍼 -> 커널 버퍼 복사
(2) 커널 버퍼 -> 상대 버퍼 복사
(3) 읽기·쓰기 시스템 호출마다 유저와 커널 사이를 드나듦
(4) 상대 스레드를 깨움
공유 메모리
(1) 데이터 쓰기 = 그냥 메모리에 쓰는 것. 복사도 시스템 호출도 없음
(2) 다 썼다고 신호를 보냄 — 여기서 커널로 들어감
(3) 상대 스레드를 깨움
=> 데이터가 클수록 격차가 크게 벌어짐. 복사 두 번이 통째로 사라지기 때문.
<-> 그런데 데이터가 작으면 격차가 작음. 남는 비용이 복사가 아니라 깨우기이기 때문임.
-> 이 문장이 다음 절의 전부임.
5. 그런데 왜 100배 느렸는가
공유 메모리로 시제품을 만들어 통신 드라이버 DLL 로 측정했음. 결과는 기존 대비 100배 가까이 느림이었음.
-> 가장 빠른 방식을 골랐는데도 그랬음. 방식 선택의 문제가 아니었다는 뜻임.
함수 호출 한 번의 실체
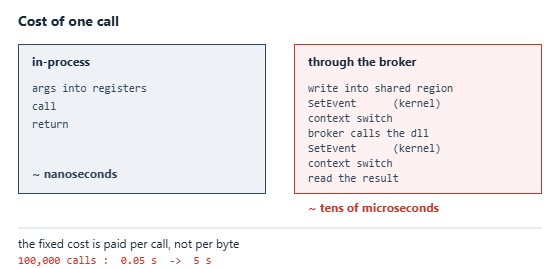
같은 프로세스 안에서 부를 때
- 인자를 레지스터에 싣고 점프함. 반환값도 레지스터로 옴.
- 명령어 몇 개면 끝남. 코드도 데이터도 캐시에 올라와 있음.
=> 나노초 단위.
중개 프로세스를 거칠 때
int CallThroughBroker(const Request& req, Response* pOut)
{
    WriteRequestInto(pView, req);        // (1) 복사 없음. 여기는 싸다

    SetEvent(hRequest);                  // (2) 유저 -> 커널 전이
                                         // (3) 상대 스레드가 실행 가능 상태가 된다

    if (WaitForSingleObject(hResponse, kTimeout) != WAIT_OBJECT_0)
        return -1;                       // (4) 내 스레드는 여기서 잠든다
                                         //     -> 컨텍스트 스위치

    ReadResponseFrom(pView, pOut);       // (8) 결과를 읽는다
    return 0;
}
- (5) 중개 프로세스가 DLL 을 부르고 결과를 공유 영역에 씀
- (6) 다시 신호 — 또 커널 전이
- (7) 내 스레드가 깨어남 — 또 컨텍스트 스위치
한 번 왕복에 커널 전이가 여러 번, 컨텍스트 스위치가 두 번 일어남.
-> 게다가 스케줄러가 상대를 즉시 실행해 준다는 보장이 없음. 다른 일이 돌고 있으면 기다림.
-> 상대가 다른 코어에서 깨어나면 캐시가 차가움. 방금 쓴 데이터를 다시 끌어와야 함.
=> 수십 마이크로초 단위.
나노초 대 마이크로초. 자릿수가 서너 개 차이남.
그런데 왜 수천 배가 아니라 100배였나
원래 호출도 공짜가 아니었기 때문임.
-> 드라이버 함수 하나가 이미 어느 정도 일을 함. 주소를 파싱하고 표를 뒤지고 값을 채움.
-> 원래 수백 나노초 걸리던 호출이 수십 마이크로초가 되면 배수는 100 언저리가 됨.
=> 배수는 원래 호출이 얼마나 짧았는지에 좌우됨.
-> 원래 무거운 함수라면 왕복 비용이 묻혀서 몇 배로 끝남.
-> 원래 가벼운 함수일수록 손해가 커짐. 가장 자주 부르는 것이 대개 가장 가벼운 함수라는 점이 고약함.
진짜 원인은 호출 횟수였다
통신 드라이버의 API 는 잘게 여러 번 부르는 형태임. 주소 하나, 블록 하나, 항목 하나 단위.
-> 한 번의 빌드에서 수만에서 수십만 번 불림.
왕복마다 고정 비용이 붙으므로 횟수가 그대로 곱해짐.
ex) 10만 번 × 50μs ≈ 5초
ex) 원래는 10만 번 × 0.5μs ≈ 0.05초
=> 문제는 대역폭이 아니라 지연이었음. 그리고 지연은 주고받는 양이 아니라 왕복 횟수에 비례함.
-> 공유 메모리가 없앤 것은 복사 비용이고, 남은 것은 왕복 비용이었음. 그런데 이 구조에서 지배적인 것이 바로 왕복 비용이었음.
=> 그래서 가장 빠른 IPC 를 골랐는데도 소용이 없었음.
줄일 수는 없었나
세 가지를 검토했고 셋 다 막혔음.
(1) 일괄 처리 — 여러 호출을 모아 한 번에 보내면 왕복이 1/N 로 줄어듦.
<-> 앞 호출의 결과가 다음 호출의 입력인 구간이 많았음. 순차 의존이라 묶을 수 없음.
<-> 묶으려면 API 를 일괄 처리형으로 바꿔야 함. 그건 이미 DLL 을 고치는 일임. 안 고치려고 시작한 일이었음.
(2) 바쁜 대기 — 잠들지 않고 응답을 계속 확인하면 컨텍스트 스위치를 피할 수 있음.
-> 지연은 실제로 크게 줄어듦. 마이크로초가 수백 나노초까지 내려가기도 함.
<-> 대신 기다리는 동안 코어 하나를 계속 태움. 편집 도구는 사용자가 쓰는 프로그램임. 배경에서 코어를 물고 있을 수 없음.
<-> 그리고 양쪽 모두 바쁜 대기를 해야 효과가 남. 코어 두 개를 태우게 됨.
(3) 경계를 위로 올리기 — 잘게 부르지 말고 "이 작업 전체"를 한 번에 넘김.
-> 왕복이 한 번이면 비용은 사라진 것과 같음. 이것이 IPC 를 제대로 쓰는 방법임.
<-> 그런데 그러려면 그 작업 전체가 중개 프로세스 안에서 끝나야 함. 그건 중개가 아니라 기능을 통째로 옮기는 것임.
<-> 범위가 완전히 달라짐. 처음 목적("DLL 은 그대로 두고 우회한다")과 맞지 않음.
6. 결론과 판단 기준
저울에 올린 것은 이랬음.
얻는 것
- DLL 을 한 벌만 관리. 수정도 빌드도 테스트도 한 번.
치르는 것
- 중개 프로세스를 새로 만들고 계속 유지해야 함
- 프로토콜을 정의하고 버전을 관리해야 함. 양쪽이 같은 바이트 배열을 똑같이 해석해야 함
- 생명주기 — 언제 띄우고 언제 내리나. 여러 개가 뜨면 어떻게 하나
- 장애 처리 — 중개가 죽으면 편집 도구는 무엇을 해야 하나. 다시 띄우나, 사용자에게 알리나
- 배포물이 하나 늘어남. 설치·업데이트·보안 검사 대상도 하나 늘어남
- 그리고 속도 100배 저하
=> 비용이 이득을 압도했음. 중개 구조를 접고 DLL 두 벌을 유지하기로 결론냈음.
두 벌 유지의 실제 비용
- 디스크 용량이 늘어남. 설치본이 커짐.
- 빌드 파이프라인이 이중화됨. 두 타깃을 모두 빌드하고 모두 테스트해야 함.
<-> 그러나 소스는 한 벌임. 타깃만 둘로 빌드하는 것이라 관리 부담이 생각보다 작음.
<-> 그리고 무엇보다 실행 시점 비용이 0 임. 사용자가 체감하는 속도가 그대로임.
=> 용량은 한 번 치르면 끝나는 비용이고, 지연은 쓸 때마다 매번 치르는 비용임. 둘은 같은 저울에 놓이지 않음.
일반화할 수 있는 기준
이 판단에서 남길 만한 것은 하나임.
-> 프로세스 분리의 비용은 주고받는 데이터의 양이 아니라 경계를 넘는 횟수에 붙음.
- 경계를 드물게, 큰 단위로 넘는 구조라면 IPC 는 훌륭한 선택임.
ex) 빌드 요청 한 번, 파일 변환 한 번, 리포트 생성 한 번.
- 경계를 잦게, 잘게 넘는 구조라면 거의 항상 짐.
ex) 값 하나 읽기, 항목 하나 검사하기, 주소 하나 변환하기.
=> 그래서 IPC 방식을 고르기 전에 초당 왕복 횟수를 먼저 세어볼 것.
-> 그 숫자가 방식 선택보다 결과를 훨씬 크게 좌우함. 파이프냐 공유 메모리냐는 그 다음 문제임.
-> 이번 건은 그 숫자가 너무 커서 어떤 방식을 골라도 답이 없는 경우였음.
7. 요약
비트수 불일치
: 32비트 프로세스와 64비트 DLL 은 포인터 크기·호출 규약·CPU 실행 모드가 달라 같은 주소 공간에 올릴 수 없고, 프로세스를 나눠 우회하면 호출마다 커널 전이와 컨텍스트 스위치가 붙어 호출이 잦은 구조에서는 가장 빠른 IPC 를 골라도 감당할 수 없게 됨.
참고할만한 포스팅
- [Window System Programming] Chapter 03. 64비트 기반 프로그래밍
- [C++] 옵션 이름이 규정하는 동작과 조용히 건너뛰는 일괄 처리
- [C++] 스키마 없는 직렬화(Schemaless Serialization)와 권한 예외 플래그의 조용한 실패
이 글이 속한 정리 · [정리] Windows 데스크톱 UI 의 함정 — DPI·다중 모니터·포커스·IME
'Develop > Practical Coding' 카테고리의 다른 글
| [C++] 읽을 때 올려주기(Upgrade on Read)와 저장 구조 버전 가드의 경계 (0) | 2026.09.18 |
|---|---|
| [C++] 표시용 문자열을 데이터로 되쓰기(Display String as Data)와 뷰 토글의 상태 관리 (0) | 2026.09.18 |
| [C++] 경로 검색의 두 단계 필터링(Two-Phase Filtering)과 탐색 캐시의 3상태 (0) | 2026.09.17 |
| [C++] 측정 프록시(Measuring Proxy)와 툴팁이라는 파생 상태 (0) | 2026.09.17 |
| [C++] 공유 선택 상태(Selection State)를 경유한 기능 재사용과 소유권 함정 (0) | 2026.09.16 |